 Posted by
На протяжении десятилетий IBM Netcool был одним из ключевых инструментов операторских центров управления сетями — NOC. Для крупных телекоммуникационных компаний Netcool/OMNIbus стал фактическим стандартом консолидации аварийных сообщений, корреляции событий и организации работы эксплуатационных подразделений.
Однако архитектура операторских сетей и сама модель бизнеса существенно изменились.
Современный оператор предоставляет не только доступ в интернет, мобильную связь или транспортные каналы. В его продуктовом портфеле появляются облачные сервисы, виртуальные АТС, корпоративные коммуникации, платформы IoT, цифровые финансовые услуги, API и приложения.
При этом качество услуги определяется уже не только исправностью сетевого оборудования. Оно зависит от взаимодействия физических ресурсов, виртуальной инфраструктуры, программных компонентов, интеграционных интерфейсов и внешних поставщиков.
Возникает принципиальный вопрос: достаточно ли оператору системы управления аварийными событиями или ему необходима единая платформа управления состоянием инфраструктуры и цифровых услуг?
Именно в этом контексте стоит рассматривать миграцию с IBM Netcool на Центральный Пульт (SAYMON).
Речь идет не просто о замене одного программного продукта другим. Это возможность объединить несколько исторически разрозненных классов OSS-инструментов: Fault Management, Performance Monitoring, Network Inventory, Service Inventory, Resource and Service Modeling и элементы CMDB.
При правильной организации миграции оператор может не только сохранить привычные процессы эксплуатации, но и перейти от управления отдельными авариями к управлению состоянием услуг и их зависимостей.
1. Почему операторы пересматривают архитектуру OSS
Исторически OSS-ландшафт крупных операторов формировался постепенно. Разные задачи решались отдельными системами, которые интегрировались между собой по мере необходимости.
Типичная архитектура могла включать:
- IBM Netcool/OMNIbus — централизованный сбор, обработку и корреляцию аварийных событий.
- IBM Network Manager — обнаружение сетевой инфраструктуры, топологию и анализ сетевых зависимостей.
- Netcracker Inventory — учет физических и логических сетевых ресурсов, сервисов и их взаимосвязей.
- Специализированные EMS/NMS — управление оборудованием конкретных производителей.
- ITSM-платформу — регистрацию инцидентов, управление изменениями и эксплуатационными процессами.
- Отдельные средства мониторинга — сбор метрик, проверку доступности, анализ журналов и сетевого трафика.
Такая архитектура решала свои задачи, но имела системный недостаток: информация о состоянии инфраструктуры, ее конфигурации и предоставляемых услугах часто находилась в разных системах.
Например, при отказе маршрутизатора оператор Netcool видит аварию, система инвентаризации знает, какие ресурсы связаны с устройством, а Service Desk содержит обращения клиентов. Чтобы определить реальное влияние отказа, необходимо объединить сведения из нескольких источников.
При этом важно учитывать, что современные продукты IBM давно вышли за рамки простого сбора аварий. Netcool Operations Insight включает аналитику событий, а Networks for Operations Insight добавляет обнаружение сетей, топологическую корреляцию и другие функции Service Assurance. Поэтому при планировании замены необходимо анализировать конкретную инсталляцию и ее состав, а не противопоставлять современную платформу устаревшему представлению о Netcool. ibm.com+1
Что меняется при переходе на Центральный Пульт
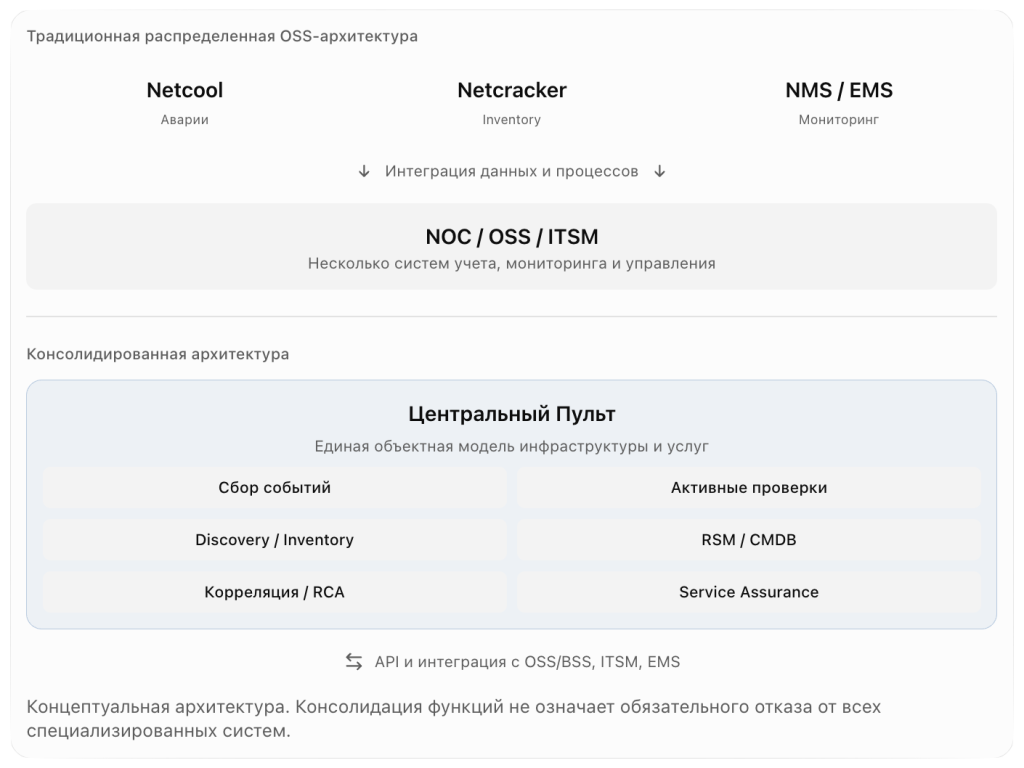
Концептуальная архитектура. Консолидация функций не означает обязательного отказа от всех специализированных систем.
Центральный Пульт позволяет строить архитектуру вокруг единой модели управляемых объектов. События, метрики, конфигурационные данные и зависимости связываются с конкретными элементами инфраструктуры и услугами.
Такой подход сокращает количество интеграционных переходов между системами и позволяет рассматривать отказ не как изолированное сообщение, а как изменение состояния определенного ресурса или сервиса.
2. От Netcool Probes к универсальному сбору событий
Одна из сильнейших сторон IBM Netcool — развитая экосистема Probes и Gateways.
Probes получают сообщения от сетевых устройств и внешних систем, разбирают их, нормализуют и передают в ObjectServer. Gateways обеспечивают обмен событиями с другими ObjectServer, базами данных, Help Desk и внешними приложениями. Сам ObjectServer выполняет дедупликацию, автоматизацию и обработку событий. ibm.com+2
Поэтому при миграции нельзя ограничиваться переносом таблицы аварий. Необходимо воспроизвести весь действующий контур сбора и обработки сообщений, включая правила преобразования, обогащение, подавление дубликатов и взаимодействие с эксплуатационными системами.
Возможности Центрального Пульта
Центральный Пульт поддерживает получение данных непосредственно от управляемых устройств, программных систем и внешних платформ.
В зависимости от источника используются как событийные механизмы, так и периодический опрос, агентский сбор и интеграционные интерфейсы.
| Источник | Возможности и применение |
|---|---|
| SNMP | Сбор метрик, SNMP Trap, мониторинг сетевого оборудования |
| Syslog | События сетевых устройств, серверов и программных компонентов |
| REST API / Webhooks | Прием данных и интеграция с внешними OSS/NMS |
| MQTT | События и телеметрия IoT и инженерной инфраструктуры |
| Prometheus | Использование существующих источников метрик |
| Kafka и другие шины | Потоковая интеграция и масштабируемый обмен данными |
| IPMI / Redfish | Состояние аппаратной платформы и BMC |
| SSH / WinRM | Диагностика и выполнение проверок на серверах |
| NetFlow / IPFIX / sFlow | Анализ сетевых потоков через NETFLOWMAN |
| Журналы приложений | Анализ эксплуатационных данных через LOGG |
Документация платформы, в частности, описывает объектно-привязанный журнал событий с поддержкой SNMP Trap и MQTT. Более широкий набор источников обеспечивается платформой и ее интеграционными компонентами. docs.cpult.ru+1
Для операторских сетей важна возможность подключать специализированные EMS/NMS и протоколы, отсутствующие в стандартной поставке. Центральный Пульт допускает разработку адаптеров, преобразующих сообщения внешних систем в общую событийную модель.
Это позволяет сохранять существующие инвестиции в системы управления оборудованием, постепенно заменяя централизованный уровень Fault Management.
Событие становится частью контекста
В классическом событийном потоке ключевыми атрибутами сообщения являются источник, время, критичность, идентификатор аварии и ее текст.
Центральный Пульт дополняет эту информацию контекстом объектной модели.
Например, сообщение Interface Down может быть связано не только с маршрутизатором и интерфейсом, но и с логическим каналом, транспортным сегментом, площадкой и предоставляемой услугой.
Это открывает возможности для корреляции событий по топологии, оценки влияния на услуги и автоматического определения ответственных подразделений.
Вместо десятков однотипных сообщений NOC получает представление о проблеме в контексте инфраструктуры.
3. Активные проверки: мониторинг не должен зависеть только от аварийных сообщений
Системы класса Fault Management традиционно уделяют большое внимание сообщениям, поступающим от управляемого оборудования. Но отсутствие аварийного сообщения еще не означает, что услуга работает корректно.
Устройство может отвечать на SNMP-запросы, а приложение — не обслуживать клиентов. Маршрутизатор может быть доступен, но качество передачи трафика окажется неприемлемым. API может возвращать HTTP 200, но при этом выдавать неверные данные.
Поэтому важное отличие Центрального Пульта заключается в наличии собственного аппарата активных проверок, который развивается наряду с механизмами событийного мониторинга.
Проверки на разных уровнях
01 – Инфраструктура
ICMP, SNMP, доступность узлов, состояние интерфейсов, CPU, память, диски и аппаратные датчики
02 – Системные компоненты
Операционные системы, процессы, службы, базы данных, контейнеры и виртуальные среды
03 – Приложения и интерфейсы
HTTP(S), TCP, API, сертификаты, ответы приложений и пользовательские сценарии проверок
04 – Сквозные цифровые услуги
Составные проверки, зависимости между ресурсами и оценка работоспособности услуги
05 – Специализированные протоколы
Расширяемые сценарии проверки телекоммуникационных и отраслевых систем
Для расширения набора проверок используются пользовательские сенсоры, скрипты, внешние агенты и интеграции. Таким образом, оператор не ограничен фиксированным перечнем устройств и технологий.
Особенно важно, что результаты активных проверок и внешние аварийные события могут анализироваться в контексте одного объекта.
Например, авария BGP-сессии может сопоставляться с изменением доступности маршрута, ростом потерь пакетов и деградацией зависимых сервисов.
Это создает основу для перехода от реактивного Fault Management к проактивному Service Assurance.
В дальнейшем аппарат проверок может расширяться специализированными синтетическими сценариями для VoIP, WebRTC, API, DNS, корпоративных коммуникаций и других цифровых услуг. Такие сценарии требуют соответствующих модулей или интеграций и не должны автоматически рассматриваться как функции базовой поставки.
4. Discovery и Inventory: замена не только Netcool, но и отдельных функций Netcracker
Один из наиболее интересных сценариев модернизации OSS — консолидация мониторинга и инвентаризации на одной технологической платформе.
В крупных операторских сетях инвентаризация исторически выделялась в самостоятельный класс систем. Продукты Netcracker Digital OSS охватывают Resource Inventory, Service Inventory, Discovery & Reconciliation, Network Planning и другие процессы жизненного цикла сети.
Это не просто база оборудования. Например, в опубликованном в марте 2026 года проекте модернизации OSS для BICS Netcracker перечисляет отдельные подсистемы Resource Inventory, Service Inventory, Discovery & Reconciliation и Network Planning & Design. Netcracker+1
В то же время не каждому оператору требуется полный функциональный охват крупной OSS-платформы. Значительная часть эксплуатационных задач связана с поддержанием актуального реестра ресурсов, их связей и влияния на предоставляемые услуги.
Именно в этой области Центральный Пульт способен заменить не только Netcool, но и часть функций специализированных Inventory-систем.
Автоматизированное обнаружение инфраструктуры
В составе экосистемы Центрального Пульта развивается подсистема автоматизированного обнаружения и инвентаризации Discovator, доступная через портал IOM.
Она предназначена для формирования и актуализации модели инфраструктуры на основании данных, получаемых из сети и внешних источников.
Возможности такого подхода включают:
- Обнаружение сетевых устройств и сбор их идентификационных и технических характеристик.
- Получение сведений об интерфейсах, адресах, конфигурации и связях.
- Формирование реестров устройств, узлов, площадок и технологических элементов.
- Импорт данных из электронных таблиц Microsoft Excel и внешних информационных систем.
- Сопоставление обнаруженных ресурсов с существующими объектами модели.
- Выявление расхождений между учетной и фактической конфигурацией инфраструктуры.
Для оператора особенно важна возможность сочетать автоматическое обнаружение с ручным и интеграционным наполнением реестра.
Не вся информация может быть получена непосредственно из сети. Например, назначение оборудования, договорная принадлежность каналов, резервирование, логические услуги и ответственность подразделений могут поступать из других OSS/BSS-систем.
Центральный Пульт позволяет объединять эти данные в одной объектной модели.
Inventory как непрерывно актуализируемая система
Традиционный реестр инфраструктуры нередко становится устаревшим практически сразу после завершения инвентаризации.
Причина проста: изменения в сети происходят постоянно, а процедуры обновления учетной системы могут выполняться с задержкой.
Интеграция Discovery и мониторинга позволяет построить другой процесс:
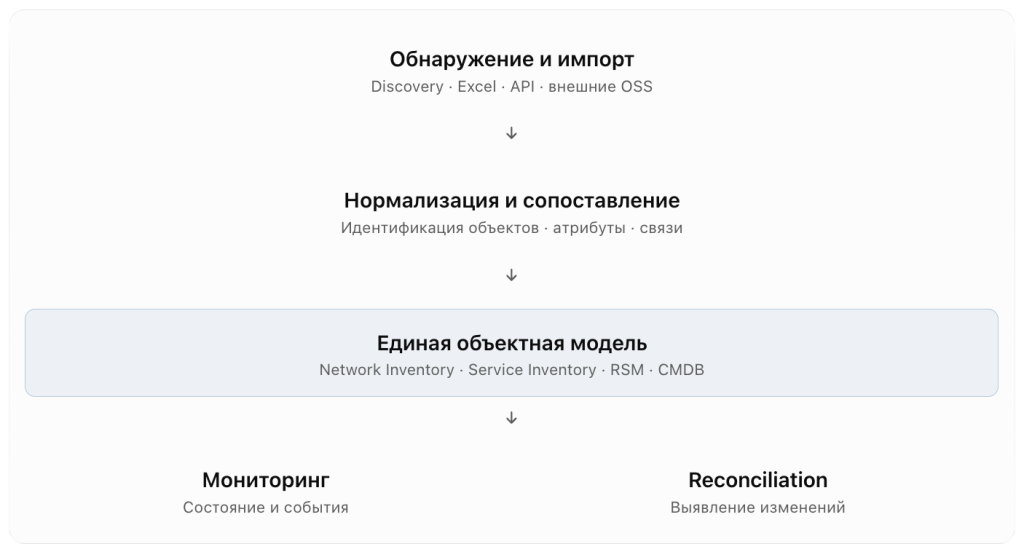
Результатом становится не статический каталог, а постоянно уточняемая модель инфраструктуры.
При этом автоматическое обнаружение не должно бесконтрольно изменять утвержденную конфигурацию. Для операторских инсталляций важно предусмотреть правила идентификации, согласования изменений, разрешения конфликтов и выбора авторитетного источника данных.
5. Объектная модель: от Network Inventory к RSM и CMDB
Ключевая архитектурная особенность Центрального Пульта — универсальная объектная модель.
Объектом может быть физическое устройство, программный компонент, интерфейс, канал, услуга, площадка или элемент бизнес-процесса.
Объекты объединяются в иерархии и могут иметь несколько родительских связей. Это позволяет описывать сложные зависимости, которые невозможно выразить обычным деревом устройств. Такая модель предусмотрена в архитектуре SAYMON и описана в документации платформы. docs.saymon.tech+1
Один ресурс — несколько представлений
Рассмотрим маршрутизатор операторской сети.
С точки зрения Network Inventory это устройство с серийным номером, моделью, интерфейсами, адресами и местоположением.
С точки зрения мониторинга — объект с метриками, проверками, событиями и текущим состоянием.
С точки зрения Service Inventory — ресурс, участвующий в предоставлении определенных услуг.
С точки зрения CMDB — конфигурационная единица (CI), связанная с другими CI, изменениями и инцидентами.
С точки зрения Resource and Service Modeling (RSM) — элемент модели, через который описываются зависимости между ресурсами и услугами.
Центральный Пульт позволяет использовать один и тот же объект во всех этих контекстах.
Это принципиально отличается от архитектуры, в которой мониторинг, инвентаризация и управление услугами оперируют независимыми идентификаторами и собственными копиями данных.
Пример: корпоративная услуга VPN
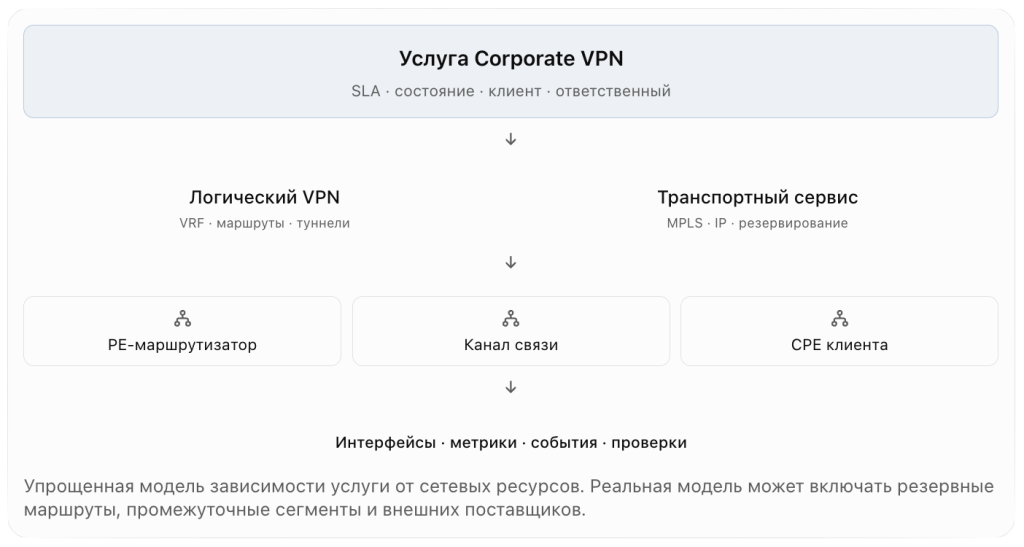
Упрощенная модель зависимости услуги от сетевых ресурсов. Реальная модель может включать резервные маршруты, промежуточные сегменты и внешних поставщиков.
Если на одном из PE-маршрутизаторов возникает авария, система может определить связанные с ним ресурсы и услуги.
При наличии модели резервирования она способна различать отказ отдельного компонента и фактическую недоступность услуги.
Это важно для сокращения ложных эскалаций и более точной оценки влияния инцидентов на клиентов.
6. Синергия eTOM и ITIL: единая модель для двух эксплуатационных подходов
Телекоммуникационные операторы исторически используют подходы TM Forum, в частности eTOM, тогда как ИТ-подразделения чаще ориентируются на ITIL.
Эти подходы не противоречат друг другу.
eTOM описывает бизнес-процессы оператора цифровых услуг, включая предоставление, эксплуатацию и обеспечение качества услуг. ITIL предлагает практики управления ИТ-услугами, инцидентами, проблемами, изменениями и конфигурациями.
TM Forum определяет eTOM как отраслевую процессную модель, а Information Framework (SID) — как общую информационную модель для операторов связи. TM Forum+1
Объектная модель Центрального Пульта позволяет построить общий информационный фундамент для обоих подходов.
| Задача | Контекст eTOM / TM Forum | Контекст ITIL |
|---|---|---|
| Учет оборудования | Resource Inventory | Configuration Management |
| Учет услуг | Service Inventory | Service Configuration |
| Обработка аварий | Resource Trouble Management | Incident Management |
| Анализ причин | Service Problem Management | Problem Management |
| Контроль изменений | Resource / Service Management | Change Enablement |
| Контроль качества | Service Quality Management | Service Level Management |
Здесь важно различать поддержку информационной модели и полноценную реализацию процессных систем.
Центральный Пульт может служить основой для хранения CI, ресурсов, услуг, связей и эксплуатационных состояний. Но наличие CMDB-модели само по себе не означает реализации всех процедур ITSM, а поддержка Service Inventory — автоматического выполнения полного цикла Service Fulfillment.
При необходимости Центральный Пульт интегрируется с существующей ITSM- или OSS/BSS-платформой, предоставляя ей актуальные сведения об инфраструктуре и состоянии услуг.
Такой подход позволяет устранить одну из традиционных проблем эксплуатации: разрыв между технической картиной сети и процессами обслуживания клиентов.
7. Корреляция событий и Root Cause Analysis
При крупном сетевом инциденте количество аварийных сообщений может исчисляться тысячами.
Отказ одного узла вызывает потерю доступности интерфейсов, каналов, серверов и приложений. Каждая подсистема сообщает о собственном нарушении, хотя первопричина может быть единственной.
IBM Netcool решает эту задачу с помощью дедупликации, правил корреляции, автоматизации ObjectServer и дополнительных средств топологического анализа. В частности, Netcool Knowledge Library содержит механизмы предварительной классификации событий и корреляции внутри устройств. ibm.com
Центральный Пульт использует сочетание правил обработки событий, состояний объектов и их зависимостей.
Платформа располагает механизмами агрегации событий и корреляции сигналов, а объектная модель создает основу для анализа влияния отказов. Подход к автоматизации RCA также описывался в материалах разработчиков платформы. Блог
От аварийного сообщения к эксплуатационному контексту
Рассмотрим типовой сценарий: отказ транспортного узла на региональной площадке.
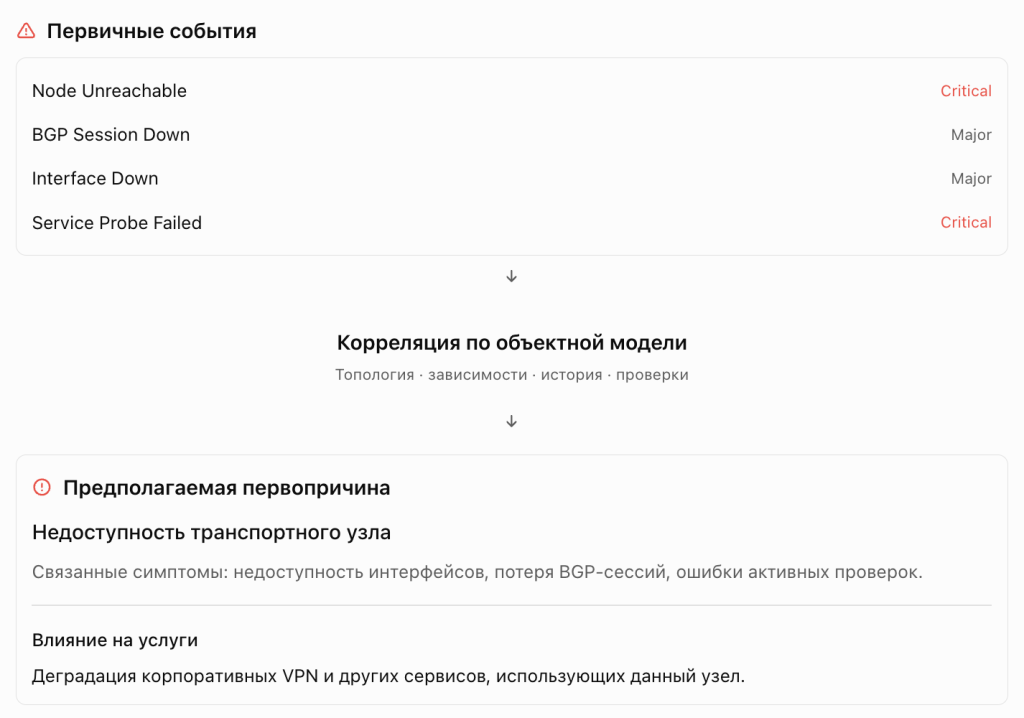
В результате эксплуатационный персонал получает не только перечень событий, но и основу для определения первопричины, приоритизации инцидента и оценки затронутых услуг.
При этом качество автоматической корреляции напрямую зависит от полноты объектной модели, достоверности зависимостей и настроенных правил. На начальном этапе миграции целесообразно использовать детерминированные алгоритмы и постепенно расширять автоматизацию.
8. Дополнительная наблюдаемость: NetFlow, Syslog и эксплуатационная аналитика
При переходе с Netcool оператор получает возможность расширить охват мониторинга за пределы классических аварийных событий.
В экосистеме Центрального Пульта для этого развиваются специализированные компоненты.
NETFLOWMAN: анализ сетевого трафика
NETFLOWMAN обеспечивает сбор и анализ потоковой телеметрии NetFlow, IPFIX, NetStream и sFlow.
Это позволяет дополнить традиционный мониторинг состояния оборудования информацией о фактическом использовании сети.
В частности, оператор может анализировать распределение трафика по узлам, адресам, протоколам, портам и сегментам, исследовать изменения нагрузки и искать источники аномальной активности.
Использование ClickHouse для хранения и обработки потоковых данных позволяет строить высокопроизводительный аналитический контур, отделенный от основной транзакционной модели мониторинга.
LOGG: журналы и эксплуатационные данные
LOGG предназначен для сбора, хранения, поиска и анализа журналов событий.
В развитии компонента предусматриваются функции аналитики приложений, APM и distributed tracing.
Совместное использование метрик, аварийных сообщений, журналов и трассировок позволяет глубже исследовать нарушения в распределенных приложениях и цифровых услугах.
Например, рост времени ответа API может сопоставляться с ошибками приложения, изменениями сетевой связности и состоянием инфраструктурных компонентов.
Таким образом, платформа развивается в направлении объединенной наблюдаемости — от состояния физических ресурсов до поведения прикладных сервисов.
9. Путь миграции: без одномоментной замены OSS
Для крупного оператора миграция с IBM Netcool — это не операция по установке нового программного обеспечения.
В действующей системе могут быть реализованы сотни правил, десятки адаптеров, сложные схемы резервирования, пользовательские инструменты NOC и интеграции с ITSM, OSS/BSS и оборудованием производителей.
Поэтому наиболее рациональный подход — последовательная миграция с периодом параллельной эксплуатации.
- Аудит существующего OSS-ландшафта
Инвентаризация ObjectServer, Probes, Gateways, правил корреляции, источников событий, интеграций и зависимых процессов. Определение критических функций, которые должны быть сохранены. - Развертывание Центрального Пульта и построение модели
Создание инфраструктуры платформы, настройка ролей, подключение Discovery и импорт существующих данных Inventory. Формирование объектов и связей. - Подключение источников событий и проверок
Последовательное подключение SNMP, Syslog, API и специализированных EMS/NMS. Разработка необходимых адаптеров. Настройка активного мониторинга. - Параллельная эксплуатация Netcool и Центрального Пульта
Сопоставление событий, контроль потерь, проверка дедупликации, корреляции и жизненного цикла аварий. Тестирование работы NOC. - Миграция Service Assurance и Inventory
Перенос моделей услуг, зависимостей, правил определения влияния на клиентов и интеграций с эксплуатационными процессами. - Переход в промышленную эксплуатацию
Поэтапное переключение доменов сети, контроль качества и производительности, вывод замещенных компонентов из эксплуатации.
Какие функции можно переносить первыми
Практически целесообразно начинать с доменов, где относительно просто обеспечить независимую проверку результатов:
| Направление | Приоритет миграции | Особенности |
|---|---|---|
| SNMP-мониторинг IP-сети | Высокий | Стандартные протоколы, проверяемые метрики |
| Syslog и базовые события | Высокий | Необходима нормализация сообщений |
| Инвентаризация IP-ресурсов | Высокий | Discovery и сверка с реестрами |
| Мониторинг серверов и приложений | Высокий | Возможность расширения активных проверок |
| Корреляция событий | Средний | Перенос существующих правил и тестирование |
| Service Inventory / RSM | Средний | Требуется согласование модели услуг |
| Специализированные EMS/NMS | Индивидуально | Зависят от доступных протоколов и API |
| Полная замена Netcracker OSS | Индивидуально | Зависит от используемых модулей и процессов |
Порядок миграции должен определяться не только технической сложностью, но и рисками для действующих эксплуатационных процессов.
Например, перенос инвентаризации может оказаться относительно простым для IP-сети, но существенно сложнее для оператора, использующего Netcracker в процессах проектирования, резервирования, назначения ресурсов и автоматической активации услуг.
В таких случаях целесообразно сохранять специализированные компоненты и заменять только те функции, которые действительно могут быть консолидированы.
Как оценивать готовность к переключению
До вывода Netcool из эксплуатации необходимо подтвердить не только полноту приема событий, но и работоспособность всей эксплуатационной цепочки.
Критериями приемки могут быть:
- Полнота получения и корректность нормализации событий из согласованного перечня источников.
- Сохранение необходимых атрибутов, критичности и идентификаторов аварий.
- Корректность открытия, обновления, подтверждения и закрытия аварий.
- Работа правил подавления, дедупликации и корреляции.
- Достоверность связей между ресурсами и услугами.
- Корректность интеграции с ITSM и внешними OSS.
- Производительность под реальной и пиковой событийной нагрузкой.
- Устойчивость к отказам, восстановление после сбоев и отсутствие потерь критических событий.
Целевые значения этих показателей должны определяться на этапе проектирования и подтверждаться испытаниями.
10. Экономика консолидации OSS
Экономический эффект миграции не ограничивается изменением стоимости программных лицензий.
Для оператора важнее совокупная стоимость владения всей эксплуатационной архитектурой.
Консолидация может уменьшить расходы на поддержку разрозненных систем, инфраструктуру, интеграционные компоненты и сопровождение нескольких независимых моделей данных.
Дополнительный эффект возникает за счет сокращения ручной работы эксплуатационного персонала, повышения качества инвентаризации и уменьшения времени диагностики инцидентов.
Однако следует учитывать и стоимость самой миграции: разработку адаптеров, перенос правил, очистку данных, обучение персонала и период параллельной эксплуатации.
Поэтому корректное технико-экономическое обоснование должно сравнивать несколько сценариев.
| Сценарий | Содержание | Основной эффект |
|---|---|---|
| Замена Netcool | Fault Management, сбор и корреляция событий | Сокращение затрат на событийный OSS-контур |
| Замена Netcool + Network Inventory | Дополнительно Discovery и учет сетевых ресурсов | Консолидация данных и эксплуатационных функций |
| Единая платформа Service Assurance | Мониторинг, Inventory, RSM/CMDB, корреляция, аналитика | Упрощение архитектуры OSS и управление услугами |
Максимальный потенциальный эффект достигается в третьем сценарии, но он требует наиболее серьезной проработки архитектуры и миграционных рисков.
11. Что дальше: AI-assisted Operations
Следующий этап развития OSS связан с использованием искусственного интеллекта для анализа эксплуатационных данных.
Для этого особенно важна качественная объектная модель.
LLM, получающая только текст аварийного сообщения, располагает ограниченным контекстом. Если же ей доступны сведения об объекте, его связях, истории изменений, метриках, журналах и зависимых услугах, возможности анализа существенно расширяются.
В развитии Центрального Пульта предусматривается применение AI-агентов для работы с эксплуатационным контекстом, базами знаний и историей инцидентов.
Потенциальные сценарии включают:
Диалог с эксплуатационной системой
Инженер задает вопрос на естественном языке: «Почему ухудшилась доступность услуги в региональном сегменте?» AI-агент анализирует доступные данные и формирует объяснение с указанием источников.
Помощь в поиске первопричин
Сопоставление текущих событий с топологией, историей инцидентов, изменениями конфигурации и эксплуатационными инструкциями.
Прогнозирование деградаций
Анализ временных рядов, адаптивные пороги и обнаружение изменений поведения инфраструктуры до наступления критического отказа.
Интеграция с внешними AI-агентами
Предоставление структурированного эксплуатационного контекста внешним интеллектуальным инструментам через контролируемые программные интерфейсы.
Эти возможности относятся к направлению развития платформы и не должны восприниматься как гарантия наличия всех перечисленных функций в текущей промышленной поставке.
При этом архитектурная предпосылка уже существует: данные об инфраструктуре, событиях и зависимостях могут объединяться вокруг общей объектной модели.
12. Заключение: модернизация OSS вместо простой замены Netcool
Переход с IBM Netcool на Центральный Пульт следует рассматривать как возможность пересмотреть архитектуру эксплуатационных систем оператора.
В минимальном сценарии Центральный Пульт способен взять на себя функции централизованного мониторинга и обработки событий, дополнив их собственным аппаратом активных проверок.
При расширении проекта автоматизированное обнаружение и инвентаризация позволяют консолидировать часть функций Network Inventory, а объектная модель — связать ресурсы с услугами и процессами эксплуатации.
Это открывает путь к объединению Fault Management, Performance Monitoring, Inventory, RSM/CMDB и Service Assurance в рамках одной платформы.
При этом речь не идет об обязательной замене всего OSS-ландшафта. Существующие EMS/NMS, ITSM, BSS и специализированные системы могут продолжать работать, используя Центральный Пульт как общий эксплуатационный и информационный слой.
Главное преимущество такой архитектуры — переход от управления разрозненными авариями и устройствами к управлению состоянием цифровых услуг на основе единой модели ресурсов, зависимостей и эксплуатационных данных.
Для операторов, развивающих облачные платформы, корпоративные коммуникации, IoT и другие цифровые сервисы, именно такой подход может стать основой следующего поколения OSS.
Материалы и источники
В статье использованы официальные материалы разработчиков и отраслевых организаций: